1. 웨이모 드라이버가 정의하는 멀티 모달리티 센서 융합
자율주행 업계에서 '카메라 기반의 비전 올인(Vision-Only)' 노선과 '다중 센서 융합(Multi-Sensor Fusion)' 노선의 대립은 여전히 가장 뜨거운 논쟁거리 중 하나입니다. 구글의 자율주행 부문 자회사인 웨이모(Waymo)는 창사 이래 줄곧 후자인 센서 융합 아키텍처를 고수해 왔는데요.
최근 공개된 웨이모의 숏폼 영상에서 Co-CEO인 디미트리 돌고프(Dimitri Dolgov)는 웨이모 드라이버(Waymo Driver)가 카메라, 라이다(LiDAR), 레이더(Radar)를 모두 사용해야만 하는 이유를 명확하게 설명했습니다. 단순히 "센서가 많으면 안전하다"는 수준을 넘어, 각 센서의 물리적 한계를 다른 센서가 어떻게 상호 보완하는지, 그리고 소프트웨어 레벨에서 이를 어떻게 하나로 엮어내는지에 대한 핵심 철학을 담고 있습니다.
💡 웨이모 드라이버(Waymo Driver) 센서 스펙 및 역할 요약
수동 카메라 (Passive Cameras): 고해상도 이미지와 컬러 정보를 제공하여 표지판 인식, 신호등 색상 구분, 객체 분류(Classification) 담당.
라이다 (LiDAR): 레이저를 조사해 주변 환경의 정밀한 3D 기하학적 구조(3D Structure)를 직접 측정. 눈부심이나 어둠의 영향을 받지 않음.
- 레이더 (Radar): 안개, 비, 먼지 등 악천후를 통과하는 전파 특성을 활용하며, 도플러 효과(Doppler Effect)를 통해 주변 객체의 상대 속도를 즉각 측정.
2. 엔지니어의 관점에서 본 센서 인코더와 융합 아키텍처
센서별 개별 인코더(Encoder) 파이프라인의 의미
디미트리 돌고프 Co-CEO의 발표 내용 중 엔지니어로서 가장 눈길이 갔던 대목은 바로 "우리 스택에서는 각 센서 모달리티마다 개별 인코더(Encoder)가 존재한다"는 점이었습니다. 이는 웨이모가 단순히 로우 데이터(Raw Data) 단계에서 결합하는 '초기 융합(Early Fusion)'이나, 각 센서가 개별적으로 인지한 객체 정보를 마지막에 합치는 '후기 융합(Late Fusion)'의 단점을 극복하기 위해 '특징 수준 융합(Feature-level / Deep Fusion)' 아키텍처를 고도화했음을 시사합니다.
카메라의 2D 픽셀 정보, 라이다의 3D 포인트 클라우드, 레이더의 도플러 텐서 데이터는 표현 형식과 차원이 완전히 다릅니다. 웨이모는 이를 각각의 딥러닝 인코더를 거쳐 고차원 특징 공간(Feature Space)으로 변환한 뒤, 트랜스포머(Transformer) 기반의 어텐션 메커니즘 등을 활용해 하나의 통일된 '3D 버드아이뷰(BEV, Bird's Eye View)' 공간으로 투영하는 방식을 사용합니다.
flowchart TD
    A["① Raw Sensors <br/> (Camera, LiDAR, Radar)"] --> B["② Modality-Specific Encoders <br/> (Feature Extraction)"]
    B --> C["③ Deep Feature Fusion <br/> (Unified BEV Space)"]
    C --> D["④ High-Precision Perception <br/> & Path Planning"]
    classDef default fill:#f8faff,stroke:#0066cc,stroke-width:1.5px,color:#222,font-size:13px;
능동형(Active) 센서가 보장하는 하드웨어적 견고함
카메라는 외부의 광원(태양광, 가로등 등)에 의존하는 수동형(Passive) 센서입니다. 따라서 역광이 강하게 비치는 석양을 정면으로 마주하거나, 가로등조차 없는 칠흑 같은 야간 도로에서는 인지 성능이 급격히 저하될 수밖에 없죠.
반면, 스스로 빛(레이저)과 전파를 쏘고 돌아오는 신호를 측정하는 라이다와 레이더는 대표적인 능동형(Active) 센서입니다. 웨이모의 시스템은 이 두 능동형 센서 덕분에 시각적 노이즈가 극대화되는 극한 환경에서도 주변의 물리적 구조를 센티미터(cm) 단위 오차로 완벽하게 복원해 냅니다. "서로가 서로의 백업(예비 수단)이 아니라, 상호 보완적인 하나의 완전체"라는 돌고프의 설명은 바로 이 물리적 상호 보완성을 두고 한 말입니다.
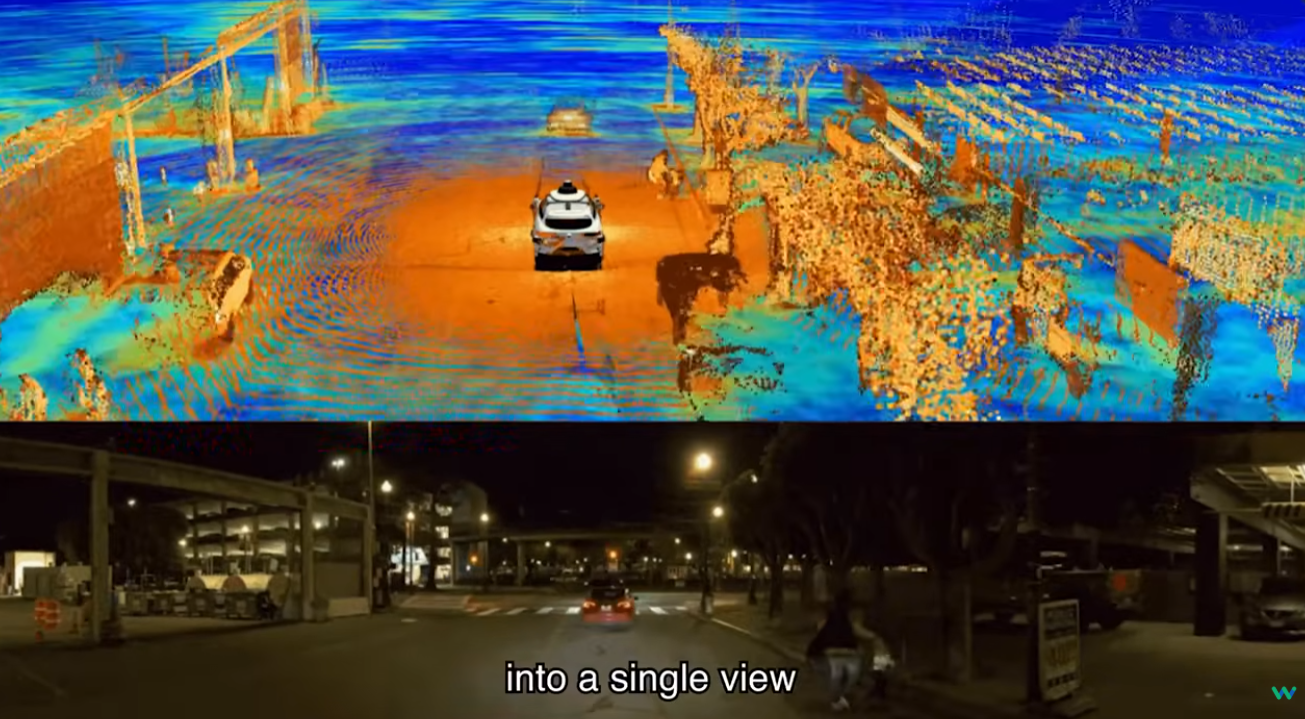
▲ 웨이모 드라이버(Waymo Driver) 센서 퓨전 실증 화면: 하단의 야간 카메라 뷰에서는 어둠과 가로등 조명 번짐으로 인해 원거리 객체의 형상 구분이 제한적이지만, 상단의 라이다 및 레이더 센서 융합 데이터는 광량의 제약 없이 360도 주변 건물, 도로 경계, 선행 차량을 단일 3D 통합 뷰(into a single view)로 센티미터(cm) 단위 정밀도로 완벽하게 재구성하고 있습니다. (출처: Waymo 공식 기술 영상 갈무리)
3. 기존 방식 대비 비교 분석 및 실무 고려사항
많은 이들이 테슬라의 비전 올인 방식이 지닌 가격 경쟁력과 양산 편의성을 칭찬하지만, 현업 실무자의 관점에서는 웨이모의 다중 센서 융합이 주는 '예측 가능성(Predictability)'과 '안전 마진(Safety Margin)'의 가치를 폄하할 수 없습니다.
- 공간 측정의 확실성: 비전 올인 방식은 2D 이미지 여러 장을 신경망(Neural Network)에 통과시켜 3D 공간을 '추론(Estimation)'합니다. 반면 웨이모는 라이다를 통해 3D 공간을 직접 '측정(Measurement)'하죠. 추론은 학습 데이터에 없는 기괴한 형태의 차량이나 장애물을 마주했을 때 착시를 일으킬 확률이 존재하지만, 직접 측정은 형태와 무관하게 "거기에 무언가 존재한다"는 사실을 100% 물리적으로 보장합니다.
- 캘리브레이션(Calibration)의 난제: 물론 센서 융합이 장점만 있는 것은 아닙니다. 차량 진동이나 온도 변화로 인해 카메라와 라이다의 정렬(Align)이 미세하게 틀어지면, 센서 간 데이터 매칭 과정에서 큰 왜곡이 발생합니다. 이를 실시간으로 보정(Online Calibration)하는 알고리즘을 유지하고 테스트하는 데는 엄청난 소프트웨어 엔지니어링 리소스가 소모됩니다.
- 컴퓨팅 오버헤드: 각 센서 모달리티마다 인코더를 개별적으로 구동하고 이들의 피처 맵(Feature Map)을 실시간으로 병합하는 연산은 차량용 하드웨어에 엄청난 부하를 줍니다. 웨이모가 차량 트렁크 공간의 상당 부분을 고성능 컴퓨팅 유닛과 냉각 시스템에 할애할 수밖에 없는 이유이기도 합니다.
4. 마치며
자율주행 기술의 궁극적인 지향점이 '운전석에 사람이 없는 완전히 무인화된 L4 로보택시'라면, 웨이모가 보여준 센서 융합 아키텍처는 현재 인류가 도달할 수 있는 가장 신뢰성 높은 정답에 가깝습니다. 하드웨어 비용과 양산성이라는 현실적인 타협안을 잠시 접어두고, 오직 '안전성'과 '롱테일(Long-tail) 에지 케이스 극복'에 초점을 맞춘다면 말이죠.
각 센서의 장점만을 극대화하여 하나의 정밀한 세계관(Single View)을 구축하는 웨이모의 소프트웨어 스택은, 센서 기술이 발전하고 컴퓨팅 칩셋의 효율이 올라갈수록 더욱 강력한 위력을 발휘할 것입니다. 하드웨어 가격 하락과 6세대 플랫폼 도입을 통해 양산성까지 확보해 나가고 있는 웨이모의 행보가 더욱 기대되는 이유입니다.


