1. Menlo Research의 Asimov 1 오픈소스 로코모션 프레임워크 공개
최근 휴머노이드 로봇 업계에서 가장 뜨거운 화두는 단연 'Sim-to-Real(시뮬레이션에서 학습한 알고리즘을 실제 로봇에 적용하는 기술)'의 완성도입니다. 아무리 가상 환경에서 화려하게 백덤블링을 돌더라도, 실제 먼지 날리고 울퉁불퉁한 현실 노면에서 단 몇 걸음도 못 가 고꾸라진다면 아무런 의미가 없기 때문인데요.
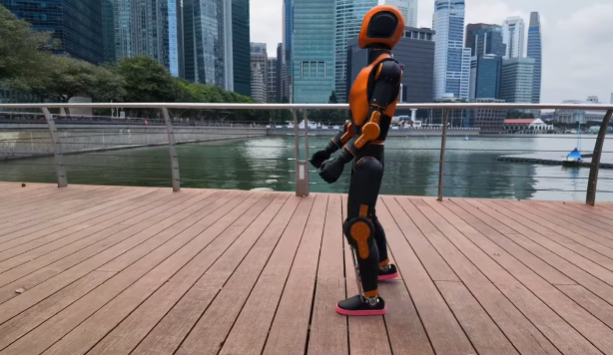
이러한 장벽을 허물기 위해 Menlo Research의 엔지니어 팀(Emre 외)이 자사의 오픈소스 휴머노이드 로봇 Asimov 1의 보행 제어 정책 및 트레이닝 파이프라인(isaac_asimov)을 전격 오픈소스로 공개했습니다. NVIDIA의 차세대 물리 시뮬레이션 플랫폼인 Isaac Lab을 기반으로 설계된 이 프레임워크는, 개발자가 수천만 원에 달하는 실제 로봇 하드웨어를 소유하지 않고도 가상 환경에서 고성능 보행 정책(Policy)을 직접 학습시키고 검증할 수 있도록 설계되었습니다.
💡 Asimov 1 로코모션 오픈소스 프레임워크 핵심 스펙 요약
- 대상 하드웨어: Menlo Research 휴머노이드 'Asimov 1' (신장 1.2m, 중량 약 35kg, 25+ 자유도, MJF 3D 프린팅 바디)
기반 시뮬레이터: NVIDIA Isaac Lab (Omniverse 기반 대규모 GPU 가속 물리 환경)
- 핵심 알고리즘: PPO (Proximal Policy Optimization) + AMP (Adversarial Motion Priors)
- 학습 요구 사양: 단일 GPU(RTX 4090 환경에서 퀵 테스트 ~10분 소요), 대규모 분산 학습(
num_envs 4096) 지원- 접근성 혁신: 실제 로봇 구매 없이도 시뮬레이션 상에서 자연스러운 보행 정책을 즉시 재현 및 튜닝 가능
2. Isaac Lab 기반의 로코모션 아키텍처 딥다이브
현업 엔지니어 관점에서 이 프레임워크의 코드를 뜯어보면, 구조가 굉장히 깔끔하게 모듈화되어 있다는 점이 눈에 띕니다. isaac_asimov는 단순한 강화학습 알고리즘의 나열이 아니라, 물리 엔진 상에서의 센서 데이터 취득부터 정책 추론, 그리고 최종 액추에이터 토크 명령까지의 파이프라인을 촘촘하게 엮어두었습니다.
전체적인 학습 및 배포 파이프라인은 아래와 같은 흐름으로 제어 루프를 형성하게 됩니다.
flowchart TD
    A["① 물리 시뮬레이션 환경<br/>(Isaac Lab / MuJoCo)"] --> B["② 상태 관측 및 모션 데이터 수집<br/>(State Observation & Reference Motion)"]
    B --> C["③ AMP Discriminator 및 PPO Policy 학습<br/>(Adversarial Motion Priors)"]
    C --> D["④ 최적 제어 정책 도출<br/>(ONNX Policy Export)"]
    D --> E["⑤ 실물 로봇 배포 및 제어<br/>(Asimov 1 Real-world Deployment)"]
    classDef default fill:#f8faff,stroke:#0066cc,stroke-width:1.5px,color:#222,font-size:13px;
기본적으로 로봇의 관절 각도, 속도, 가속도 및 IMU 센서 데이터가 입력값(Observation)으로 들어오면, 뉴럴 네트워크 기반의 Policy가 최적의 모터 타겟 위치나 토크 값을 계산해 냅니다. 이 과정에서 Menlo Research는 대규모 병렬 연산을 위해 수천 개의 가상 환경(num_envs 4096)을 동시에 띄워 학습 속도를 극적으로 끌어올리는 방식을 취하고 있습니다.
AMP(Adversarial Motion Priors)를 활용한 모션 모방의 묘미
여기서 핵심 디테일은 바로 AMP(적대적 모션 모방)의 도입입니다. 일반적인 PPO(Proximal Policy Optimization) 알고리즘만 사용해 로봇을 학습시키면, 로봇은 오직 '넘어지지 않고 목표 속도에 도달하는 것'에만 몰두합니다. 그 결과, 시뮬레이션 안에서 기괴하게 관절을 꺾으며 게걸음으로 걷거나, 에너지 효율이 극도로 떨어지는 우스꽝스러운 자세로 목적지에 도달하는 소위 '시뮬레이터 핵(Simulator Hack)' 현상이 발생하곤 합니다.
AMP는 GAN(적대적 생성 신경망)의 판별기(Discriminator) 개념을 도입하여 이 문제를 해결합니다. 실제 인간이나 잘 다듬어진 로봇의 자연스러운 보행 데이터를 '참조 데이터(Reference Motion)'로 주고, 판별기가 "지금 로봇의 움직임이 자연스러운가?"를 지속적으로 평가하게 만듭니다. 결과적으로 로봇은 넘어지지 않는 미션을 수행하면서도, 최대한 인간에 가까운 우아하고 안정적인 걸음걸이를 스스로 학습하게 됩니다.
3. 엔지니어가 반드시 뜯어봐야 할 3대 핵심 튜닝 포인트 (Sim-to-Real 실전 가이드)
Menlo Research의 개발자(Emre)가 레딧 커뮤니티 및 릴리즈 문서에서 직접 강조했듯, 이 프레임워크를 자신의 로봇 하드웨어에 적용하거나 연구에 활용하려는 엔지니어라면 다음 3가지 핵심 구성 요소를 집중적으로 분석해야 합니다.
① 보상 함수(Rewards) 세부 항목과 가중치 배분
강화학습 정책의 성패는 결국 '무엇을 유도하고 무엇을 억제할 것인가'를 정의하는 보상 함수에 달려 있습니다. isaac_asimov는 목표 전진/선회 속도 추종 보상뿐만 아니라, 관절 가속도 억제, 발바닥 접지 충격 완화, 상체 롤/피치 각도 유지, 에너지 소모량 페널티 등 세부적인 항목(Individual terms)과 정밀한 가중치(Weights)가 정의되어 있습니다. 목표 속도에만 치중하면 모터 과열이나 떨림(Jittering)이 발생하므로, 페널티 텀 간의 균형을 맞추는 것이 핵심입니다.
② 액추에이터 응답성(Actuator Configuration) 모델링
시뮬레이션과 현실이 괴리되는 가장 큰 원인은 '모터가 이상적으로 즉각 반응하지 않는다'는 점입니다. Menlo Research는 각 조인트의 P/D 게인(Gains)과 응답 지연 시간(Actuator Delays)에 대한 가정을 파라미터화해 두었습니다. 만약 Asimov 1이 아닌 다른 감속비나 다른 규격의 BLDC 모터(예: 준직접구동 QDD 또는 사이클로이드 모터)를 탑재한 하드웨어로 정책을 이식하려 한다면, 이 액추에이터 파이프라인의 물리 모델을 먼저 실제 모터 벤치마크 데이터와 일치시켜야(System Identification) 정책이 깨지지 않습니다.
③ 도메인 랜덤화(Domain Randomization)와 외란 내성
현실 세계는 마찰력도 불균일하고 바람이나 외력이 수시로 작용합니다. 이 프레임워크는 학습 루프 내에 극단적인 랜덤화를 주입합니다:
- 발바닥 마찰계수(Foot Friction) 변동: 미끄러운 대리석부터 거친 아스팔트까지 대응
- 모터 게인 변동 및 상체 무게중심(Torso CoM) 오차: 배터리나 센서 추가 장착 시 발생하는 질량 중심 이동을 사전 학습
- 관측 노이즈(Observation Noise) 및 가상 외란(Simulated Pushes): 시뮬레이션 중 로봇의 몸통을 불시에 밀쳐내는 외란을 가해 비틀거림 후 즉시 자세를 회복하는 복원력 훈련
💡 실무자를 위한 단계별 튜닝 워크플로우 팁
"처음부터 여러 파라미터를 동시에 바꾸지 마세요. 먼저 공식 베이스라인(
Asimov1-Velocity-AMP-v0)을 시뮬레이션에서 100% 동일하게 재현한 뒤, 단 한 가지 세팅(예: 발 마찰력이나 액추에이터 딜레이)만 변경하여 보행 걸음걸이(Gait)에 어떤 변화가 생기는지 동일 조건에서 A/B 테스트하는 것이 가장 확실한 분석 접근법입니다."
실무 컴퓨팅 팁: 단일 GPU vs 분산 학습
Menlo Research는 베이스라인 풀 트레이닝을 위해 RTX A6000이나 RTX PRO 6000 수준의 워크스테이션 환경을 권장하지만, 개발자용 플래그십 카드인 RTX 4090 단일 환경에서도 --num_envs 128 옵션을 주면 약 10분 만에 퀵 테스트(100 iterations) 완료가 가능합니다. VRAM 한계에 맞춰 환경 수를 조절한 뒤, PyTorch 분산 처리(torch.distributed.run)를 적용해 멀티 GPU 환경으로 스케일업하는 전략이 실무적으로 권장됩니다.
4. 마치며
Menlo Research의 Asimov 1 로코모션 프레임워크 공개는 오픈소스 로보틱스 진영에 아주 신선한 자극입니다. 독자적인 하드웨어를 개발하면서도 소프트웨어 스택의 핵심인 물리 시뮬레이션 및 강화학습 파이프라인을 투명하게 공개한 덕분에, 이제 중소 개발사나 대학 연구소에서도 고가의 독점 플랫폼 없이 수준 높은 휴머노이드 보행 제어를 실험해 볼 수 있게 되었네요.
특히 "로봇을 소유하지 않고도(Without owning the robot) 시뮬레이션 상에서 자유롭게 연구할 수 있다"는 철학은, 소프트웨어 엔지니어들이 하드웨어 제약 없이 피지컬 AI(Physical AI) 영역으로 진입할 수 있는 가장 훌륭한 디딤돌이 될 것입니다. 시뮬레이션에서 잘 빚어진 보행 지능이 앞으로 더 다양한 양산형 로봇 바디에 이식되기를 기대해 봅니다.
참고 자료 (References)
- 공식 원문 (GitHub): Menlo Research / isaac_asimov Repository
- 커뮤니티 발표 (Reddit): Reddit r/robotics - Asimov 1's locomotion policy + training code is now open-source
- 제작사 공식 사이트: Menlo Research Official


